2023年2月23日 星期四

繪圖AI - Midjourney 註冊方法與基本使用教學


其實利用人工智慧來進行繪圖,其實已經發展很久,只是大家一直沒有過多的重視,在先前比較被討論的議題是透過AI來進行換臉製作影片,相關問題甚至引發了一起社會事件,而這也是AI繪圖的重要應用之一。

 其實就在前幾年大家熱衷於利用顯示卡來挖礦時,就有另外一批人在研究如何利用顯示卡來訓練AI進行繪圖了,隨著這幾年 AI 的進步與顯示卡運算能力越來越強大,就2022年8月底美國的科羅拉多州博覽會美術大賽,一張由Midjourney人工智慧「輔助」創作的作品奪得大獎,才讓人意識到AI繪圖已經如此強大,更是掀起了大眾對AI使用的輿論。

 無論AI的應用爭議如何,新的技術產生,其實對設計者或創作者而言就是多了一項新的工具,我覺得人工智慧的發展,有時不是在複製人類而已,AI是完全不同的另外一種存在。而且對很多事情來說,不用擔心AI會提高我們的涉入門檻,相對的AI是,是降低了參與門檻。而降低門檻不代表一定就會被AI取代,想想傳統相機、傻瓜相機與智慧手機對攝影這件事的影響,攝影不但沒有消失,反而因為新工具而更為蓬勃。因此我們可以這麼想,AI可以是人創意(想法)的延伸,它是人部分能力的替代。只要我們要善用數位工具,AI是我們的幫手。

 最近最主流且最被熱議的AI人工智慧繪圖,想必就是Midjourney這套軟體了,我們通常簡稱為MJ。近期Midjourney已經開發到V4,發展到更不容易看出 是AI 生成的痕跡,只要妥善應用,在某些地方已經能做到極為細緻的概念設計圖。不只可以提供設計師進行腦力激盪、構想發展的提案,甚至有機會達到了可以直接生產設計或是藝術級高質量成品的地步,成果令人驚艷。

 而Midjourney的應用也相當簡單,幾乎沒有任何門檻,唯一的門檻可能只是想像力而已。MJ這類的AI繪圖都是利用輸入關鍵字即可生成影像的AI繪圖網站。這類的網站很多,真的可以說是如雨後春筍般蓬勃發展,其中最知名的還有

https://novelai.net/

https://stablediffusionweb.com/

https://openai.com/dall-e-2/

https://playgroundai.com/ 


今天我們的重點在介紹大家公認效果最好的Midjourney,因為MJ生成的影像不限於單一風格,平面、3D、水彩...等等,甚至包含產品設計。你也可將不同風格的圖像、作者、材質整合在單一圖片裡。尤其是我本身是工業設計師,我更在意的是利用AI來進行構想發展、產品設計圖的表現,而這方面MJ的表現是極為優異的。

 以下就來介紹Midjourney的帳號申請與基本使用方式。

 使用步驟1:-登入MJ與註冊Discord

首先,進入MJ的官網,連結如下:

https://midjourney.com

可以在畫面右下角,看見" Join the Beta",請點擊進入。


進入後,就會連結到
Discord,因為Midjourney是架構在Discord下,所以必須要有Discord的帳號才能使用Midjourney的功能。

如果你沒有Discord帳號,網頁會引導你建立帳號,你可以用你的FB或GOOGLE帳號來建立,如果你已經有帳號或已經有先安裝在電腦上,網頁會直接開啟你的應用程式。


要 AI 自動運算圖片的話,進入左側newbies 系列的聊天頻道,畫面上有newbies-118、newbies-148、newbies-178三個頻道,進入任何一個都可以。

右側可以看到已經有很多人一直不斷在生成新的圖片,你可參考其他人使用的關鍵字。如畫面上的這個網友,就是使用了"otter smoking a ciga"這組關鍵提詞,產生了這個畫面。


提醒一下,在我們輸入第一組訊息以後,會先跑出尚未同意服務條款的通知。
按下綠色按鈕「Accept ToS」同意。關於這些條款,包含了以下的內容:
  • 禁止成人、血腥、驚悚、不安、具攻擊性、暴力、騷擾等內容。
  • 未經他人同意不可公開分享其作品。
  • 不可商用。
  • 重製、二創等相關規範請參閱免費使用者授權條款全文。

如果有興趣了解更詳細的規範以機關於著作權的內容,請到官方網站上去,有非常詳盡的說明。以下連結為官方的說明:


使用步驟2:基本操作
每個人約有25個免費次數,用完就要付費,付費方案有多種,請依使用量去考量。
Midjourney只能輸入英文,可先用google翻譯你要的作品敘述。

基本操作流程如下:
  1. 輸入「/imagine」+任何字
  2. 伺服器的機器人會在1分鐘左右會給你4張概念圖
  3. 點選下方數字按鈕以取得「Upscale(U)」或「Variations(V)」
  4. -Upscale(U):完稿,將圖畫完成並放大尺寸。
  5. -Variations(V):再產生4張類似的概念圖。
操作方法是在對話框內按+號選"應用程式",或輸入/,就會出現功能選項。
點選或輸入「/imagine」就會在上方出現符合的指令。通常輸入第一個字母就會有選單可以選擇。
在prompt後面開始輸入關鍵字或句子,語言號稱不限,但測試後還是英文比較準確,強烈建議使用英文,完成後按下Enter送出。


輸入「/info」是顯示個人資訊,如訂閱方案、目前使用量等。這個資訊就算是在聊天室中輸入,也是只有自己看得到的,你可以從這裡看你的免費算圖次數還剩下幾次。


如果你覺得聊天室裡面人太多了,畫面更新太快,你找不到自己生成的圖面,可以在網頁右上方,有一個#號那邊,進入去建立一個自己的聊天串,雖然別人也可以進入你的聊天串,但理論上不太會有人進來,就算有也不多,這樣就可以比較不會被畫面一直生成新圖所困擾。

不過我也很喜歡在這個公眾的聊天室,看看大家的作品,以及大家的使用技巧,成長會很快速。


舉例說明:
下面這張喇叭的圖,是使用了這個提詞:Bluetooth speaker, red silver colors, unique styling, organic form, product design rendering, realistic photograph, studio lighting -- v4 -- ar 3:2 --upbeat
  • 敘述可以是一段文字,或是個別的單字。每個單詞或是敘述,需要用逗號分開。
  • 完成後會出現選項左上到右下U1~4、V1~4的按鈕。
  • U(Upscale)是放大,V(Variations)是此風格再發展4張。
  • 敘述最後面加的是參數-- v4(第四版運算風格) -- ar 3:2(圖面比例)
  • 補充說明,還可以加入風格、設計師、畫家、工作室的名稱,改變整體氛圍。


以下我們就來實際進行實際操作,我用時下蠻有名的漫畫作品"我的英雄學院"的主角綠谷出久來當作時實驗對象。由於這是個知名的漫畫作品,其實只要輸入主角的名字"DEKU"AI就能進行繪圖,但建議還是完整一點會比較好。

我輸入:deku, My Hero Academia


由於我沒有輸入太多條件,因此AI就隨意的生成。再來我再增加其他的元素。
例如,我想要風格寫實一點,所以我加入"realistic"這個單字。
我輸入:deku, my hero academia, realistic


可以看到,真實感增加了,比較像是3D繪圖作品的效果。這時候,如果覺得真實的效果不好,脫離了原作,我想比較貼近原作的漫畫效果,這時候我在加入兩個元素,一個是"sketch"素描繪圖效果,加上作者風格"style of Kohei Horikoshi"。
我輸入:deku, my hero academia, sketch, style of Kohei Horikoshi
我們就得到了下圖的效果,這就是基本的操作概念,你可以在持續增加各種不同的元素或風格,包含背景的描述、燈光的描述、鏡頭角度的描述、服裝的描述等等等。


我們可以利用這個案例來進行了解,我們來繪製一張椅子。
最簡單的方式,其實可以用設計師的風格來加入,我用一個風格強烈的近代知名設計師Karim Rashid(卡里姆·拉希德)來測試,看看AI是不是有掌握這位知名設計師的風格。
我輸入:chair design by Karim Rashid 


測試結果,椅子造型雖然誇張,但AI掌握的風格還算滿準確的。如果是個成熟的設計師,已經能夠從AI提供的圖面去擷取元素出來進行設計了。

整合上面所講的重點,我想要做一張現代風格木製單椅設計,要有點設計手繪的哪種風格的圖面。我們可以做一個有效的統整,我們的敘述可以從形容詞+主題、鏡頭、光源、背景、角度、風格,這樣整合在一起,並加最後加上算圖版本和比例。

提詞如下:

a beautiful modern wooden chair design, handcraft, wide shot, daylight, product cinematography, low angle, detailed, white paper background, sleek design, digital sketching style, --v 4 --ar 3:2

美麗的現代木椅設計,手工藝,廣角鏡頭,日光,產品攝影,低角度,詳細,白色背景,時尚設計,數字素描風格 --v 4 --ar 3:2 


第一次計算,裡面有兩張我覺得是不錯的,也算是完整,如果不滿意,可以按下U4旁邊藍色的那個重新計算符號,你可以直接以相同的提詞重新計算一次,也可以重新修正提詞後,在計算一次。我就直接請他利用這此提詞再算一次。AI計算結果基本上每次都不同,採用隨機性的SEED運算,所以幾乎是無法重現的。


假設,我覺得第三張會有發展性,是比較接近我想要的,我想要用這張為基礎再發展四張,這時候你就按下V3的按鈕,就會以這個為基礎再發展四張。


最後我們選定一張喜歡的,在進行放大,並另存圖面下來即可。加設我選擇第二張,我就按下U2,我會把這張的成果直接1:1貼到下方。


如果是工業設計領域的朋友,這些關鍵字也可以,idea sketch / product rendering / product design sketch / design hand sketch,大家可以分別試試,會有不同的效果。

另外,關於MJ的相關資源,可以參考下列網站:
MidJourney資源懶人包
Midjourney Documentation|官方說明手冊 (最新版)
Midjourney Documentation|官方說明手冊
Midjourney Dictionary|官方字典
Midjourney Styles|官方風格

官方網站


以上就是本次的教學說明,我們之後會在進行進階的使用示範,如果還有什麼問題也歡迎留言進行交流。

2023年2月22日 星期三

繪圖AI - Stable Diffusion 最強外掛模組ControlNet安裝教學與參考資源


最近一個叫做ControlNet的軟體橫空出世,在AI繪圖圈子裏面掀起一陣熱議,因為這套軟體解決了AI繪圖上一個很大的問題,就是人物或是物體的姿勢或是擺放的問題,ControlNet的出現讓我們在控制AI繪圖上提供了巨大的幫助。

ControlNet其實嚴格上來說不是所謂的軟體,他是Stable diffusion一個外掛模組(插件),ControlNet 是一種全新的神經網絡結構,允許通過使用不同的特殊模型,從任何圖像建立出一組參考架構,並使用這些參考架構將AI產生的繪圖數據,參考這個架構圖像,轉換到到另一個新生成的圖像上。

簡單的說,就是在AI產圖之初就將一個圖形的輪廓提取,先生成在最一開始的圖中,再由AI去補剩下的東西,而我們提供的參考圖或是草圖,就可以約束或限制AI的發展,使AI能夠繪製出我們指定的型態。

以下圖為例,我提供AI一組草圖,AI就依照這組草圖,生成了這個型態。


這對做設計工作的我來說,有莫大的幫助。


關於這個外掛模組的詳細介紹,可以參考下列這個網址的資訊,這是他們官方發布的內容,有完整的計數與使用資料。

https://github.com/lllyasviel/ControlNet


以下,我們就來說明安裝與使用的方法,安裝外掛模組前,當然主程式Stable diffusion要先安裝好,如果還沒安裝請參考我上一篇的介紹文章:


步驟1.安裝外掛模組

在上面官網的介紹網頁中,也有介紹了安裝的方法,有需要的朋友也可以直接看原文資料,我們的安裝方式也是參考官網的說明。


這是ControlNet的安裝有兩三種方式,包含使用GIT載下來然後丟到extensions資料夾裡;使用DOS指令方式執行PowerShell的方式;以及直接使用WebUI載下;如果你的Stable diffusion webui有更新的話,我建議直接使用WebUI更新比較方便,官網的標準安裝方式也是這個方法,我們在Extensions(中文版名稱擴充)頁簽進行安裝即可。

 選擇”擴充”(Extensions),然後選擇”從網址安裝”(Install from URL),在網址處填入https://github.com/Mikubill/sd-webui-controlnet.git,然後點擊安裝。


安裝好了以後,選”已安裝”(Installed)這個頁籤,就會出現你安裝的擴充項目” sd-webui-controlnet” ,並按下重新啟動介面的按鈕,介面重新載入後,就安裝完成了。


步驟2.下載模組(模型)

ControlNet的模組安裝與其他的模型下載方式是一樣的,網址如下:

完整版

https://huggingface.co/lllyasviel/ControlNet/tree/main/models

精簡版

https://huggingface.co/webui/ControlNet-modules-safetensors/tree/main


他總共有8種,每一種模組的功能可以參考先前的官方網頁,有詳細介紹,下面表格是網友這裡的資料。

模組

效果

Canny

會用演算法詳細的抓圖片的邊緣線做為參考生成圖片

mlsd

會嘗試抓圖片中明顯的直線做為參考生成圖片

hed

會嘗試抓取圖片中的特徵做為參考生成圖片

Scribbles

會嘗試以提供的線條為結構做為參考生成圖片

openpose

會嘗試從圖片中的人物生成骨架後做為參考生成圖片

seg

會將圖片用一個大略的色塊取代後做為參考生成圖片

depth

會嘗試從圖片中抓取圖片的深淺遠近做為參考生成圖片

normal

與depth類似,也會嘗試從圖片中抓取圖片的深淺遠近做為參考生成圖片


由於全部八種模組全部抓下來,包含整個安裝大概需要40G的空間,如果硬碟空間不夠大也不一定要全部都裝,我個人建議安裝Canny、openpose、Scribbles這三個模組。


完整版模組,每一個模組大小就5.71GB,容量相當的大。


精簡版模組大小


下載你需要的模組完成後,請把他們放在

x:\stable-diffusion-webui\extensions\sd-webui-controlnet\models

完成後再重新載入一次,模組才會出現在webui中,我個人則是使用完整版,且全部下載。


我推薦的三個模組,我就用官網上的介紹來稍微說明一下。

Canny:會用演算法詳細的抓圖片的邊緣線做為參考,進一步生成圖片,所以所有細節都會被產生出來,人物照片為例,這個人不只是動作,連衣服的型態都會被帶出邊緣,因此AI重繪的還原度會很高。

以下面的鳥為例,包含姿態、五官、白色的腹部區域、腳下的木頭,都能準確生成。主要的應用就是提供彩色的照片,以設計為例的話,假設我們提供一張彩色的表現技法圖,AI就可以協助生成更為逼真的擬真照片。


Scribbles:以我們提供參考的線條為結構做為參考生成圖片,這個非常適合作工業設計的我們,當我們完成設計草圖時,就可以提供AI去生成精密描寫圖。因此,手稿的透視、比例、準確度就變得更為重要了。


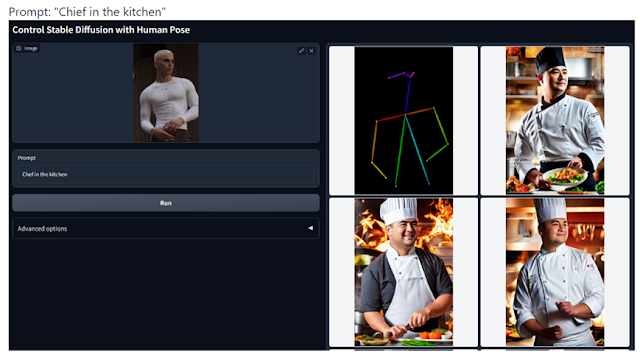
Openpose:如何讓AI繪製人物時,能夠擺出正確的姿勢一直讓人很困擾,這個模組會嘗試從圖片中的人物生成骨架,然後依照骨架做為參考生成圖片。之後利用關鍵字控制人物的造型、服裝、場景等等,但動作是不會改變的。與先前Canny不同的是,Openpose是由圖片產生人體架構,Canny則是產生出照片中人物的邊緣輪廓,因此Canny生成會很貼近原本的照片,而Openpose可以透過關鍵提詞改變更多型態。


3.使用方法

外掛的這個插件安裝完畢後,理論上在txt2img應該會看到多了Controlnet,如果你只有在img2img看到Controlnet(如果你發現介面不太一樣,我建議你更新webui)。


 點開之後會看到這個畫面,請把下方的ControlNET打開。開啟後畫面如下,可以看到各種功能。


l   首先勾選enable,才會啟動Controlnet。


接下來還有三個選項,用途如下。

Scribbles mode:是給Scribbles專用的,其他的模式不需要開啟,如果有用到再開,Scribbles的功能我們下次再介紹。

RGB to BGR:反轉紅與藍,原理是利用顏色反轉去產生對比,我不太確定有什麼效果,目前看不太出來顯著性,因此暫時不使用。

low VRAM:如果你顯卡RAM不夠,請勾選它。但倒底多少是不夠,我沒有看到相關說明,以我自己3050Ti 4G來看,我測試上感覺不出顯著差異。但以AI繪圖的架構來看,以往不到8G都算是不夠,所以不到8G的顯卡就勾吧。


Preprocessor 與 Model就是選前面提到的模組,不管你是下載全部還是我建議的那三個,兩個請選相同的模組,如在Preprocessor選了Scribbles,那麼Model也請選Scribbles用的,才能得到我們想要的結果。


Weight:是Controlnet的權重,也就是強度,有國外的網友整裡出了強度影響的對照表,總之我覺得1是比較剛好的。

Resize mode:設定輸入的圖片要怎麼和下方設定的寬度與高度對應,這部分跟SD在圖生圖選項中,關於長寬比的設定是相同的。

最下面的Create blank canvas則是在圖片的地方生一個空白圖片讓你畫,也就是提供給Scribbles塗鴉模式用的,暫時用不到。


關於權重的說明


來自NEXT-GEN NEW IMG2IMG In Stable Diffusion! This Is TRULY INCREDIBLE


其他操作就跟原本的SD操作式相同的,就不多作介紹了,詳細的應用方式,我們之後再專文說明。以我的電腦為例,以前產出一張圖是約1分鐘內,是用ControlNET就會發現時間大幅增加到3~5分鐘,差異非常顯著。


以下兩張照片,就是目前的測試畫面,提供參考。


2023年2月19日 星期日

繪圖AI - Stable Diffusion 相關安裝教學與參考資源

繪圖AI - Stable Diffusion 相關安裝教學與參考資源

 
Stable Diffusion、Noval AI是近期發展知名的AI繪圖軟體,其中Noval AI更是日本畫師最愛的日式動漫風格AI繪圖,Stable Diffusion、Noval AI的發展都跟時下最熱門的Midjourney一樣,是在網路上執行的,網址如下:

https://novelai.net/

https://stablediffusionweb.com/

但Stable Diffusion除了網頁上執行,還可以安裝於個人電腦,更方便我們使用。Stable Diffusion這類的AI繪圖先不講其技術原理,單純以簡單的使用角度來說,他核心就使以兩種模式來產生圖片,分別是txt2img與img2img,就像這麼名稱的字面意思一樣名:

txt2img:文字轉影像,你輸入文字(一般又稱prompt/提詞/關鍵字)來產生圖。

img2img:影像轉影像,你提供參考圖,AI依據參考圖產生新的圖。

Stable Diffusion是一種開源的程式,是完全免費的算圖工具之一,由於它是開源程式,因此它集合了眾人之力所以更新速度很快,但也不像真的應用程式,有簡便的安裝方式與方便、美觀的介面。以下提供的安裝方式有點麻煩,但在開源軟體的世界,這算是正常的。

整個安裝過程,可以參考下列這個網站:

https://rentry.org/voldy

這個網站也是集結眾人之力,合作完成的資料,資料完整度非常高,從技術簡介、安裝方式到軟體的使用教學,說明得相當完整,只要依照網站提供的步驟,就能完成安裝,如果有興趣進一步了解的朋友,建議參考這個網站。

在我們開始安裝說明之前,我們先了解一下硬體規格需求

最低要求:

-16gb ram

-Nvidia Maxwell (GTX 7xx) 或更新的 GPU,至少2gb vram

-Linux 或 Windows 7/8/10+

-20gb 磁盤空間

其中要特別說明的是關於顯卡,AI繪圖對於顯卡的要求非常高,因此還是建議有較好顯卡的電腦再來安裝,建議顯卡的記憶體越大越好,基本上它的運算是使用顯卡的GPU進行的。

另外,除了基本程式所需的空間外,它還需要下載各種不同風格的模組,才能有參考的資料庫可以進行運算,因此需要非常大的硬碟空間,建議最好能騰出80G以上的空間是最好的。


步驟1: 安裝Python

Python3.10.6官方載點:https://www.python.org/downloads/release/python-3106/

Python可以視為是一種程式語言,請你依照你的電腦下載對應的版本。一般我們現在使用的windws系統電腦,就直接選最下面的那個64位元的連結即可。現在已經很少32位元的電腦了。


下載完安裝時這個,下方路徑需要打勾,尤其是最下方的那一個。


步驟2: 安裝 Git

檔案連結:https://github.com/git-for-windows/git/releases/download/v2.37.3.windows.1/Git-2.37.3-64-bit.exe

完整網站:https://git-scm.com/download/win


步驟3:複製主程式

這個程式我們通常稱為AUTOMATIC1111,使用的介面是WebUI

在桌面空白處按滑鼠右鍵,會看見選單多了兩項,請選擇 “Git Gui Here”。跳出視窗後,選擇中間的選項” Clone Existing Repository”。


這是要將主程式” Clone克隆”複製到你的電腦。請輸入以下的位址到上方來源的空格:

https://github.com/AUTOMATIC1111/stable-diffusion-webui.git

然後,按下方的瀏覽,選擇你要安裝的路徑,接下來就會把程式安裝到指定位置。


步驟4:下載模組

SD的模組非常多,有許多網友也會自行訓練模組再分享到網站。以下是模組的下載網站,我建議可以先下載

https://huggingface.co/models?pipeline_tag=text-to-image&sort=downloads

我推薦的模組,可以先下載這幾個

https://huggingface.co/stabilityai/stable-diffusion-2

風格多元,資料完整,整體效果非常好。

https://huggingface.co/prompthero/openjourney

模仿Midjourney -v4 style

https://huggingface.co/Linaqruf/anything-v3.0

這是日式動漫畫風,是目前最受歡迎的模組,Anything已經出到V4的版本,但V4比較寫實一點,還是很多人喜歡V3的風格。

模組通常有 .safetensors 和.ckpt兩種格式,會建議下載.safetensors的格式,之後使用時,載入的時間比較短,而且安全性也必較高。

以stable-diffusion-2的安裝為例,進入huggingface網頁後,可以在介紹頁面中看到有三個分頁標籤:Model card、Files and versions、Community。

預設的Model card中看它的功能、使用說明和使用限制等等。

點選Files and versions可以到檔案下載的頁面。點選副檔名.safetensors 和.ckpt兩種格式後面的向下的小箭頭,就可以把檔案下載下來了。


步驟5:安裝模組

將下載好的模組,放到你的安裝路徑下,這就要看你是把安裝路徑放在什麼地方了,以下為路徑位置。

X:\stable-diffusion-webui\models\Stable-diffusion

將下載好的檔案,以剪下貼上的方式,放在這個位置就可以了。

有的模組需要搭配.yaml或vae.pt的檔案,但目前多數的情況下可以不必,所以只要把模組放在指定的資料夾後,就可以運行。


步驟6:中文化

這個動作不是必需的,而中文化的檔案也不是官方推出的,是網友們自行製作的,所以如果之後版本更新,而網友沒有人製作,那也會沒有中文化的檔案。檔案請放在這個位置。

X:\stable-diffusion-webui\localizations

網友分享的中文化檔案連結如下:

https://drive.google.com/file/d/1-cmqR4S8rUrg6D4EeWYhzgZmNs5iSpNd/view


步驟7:調整批次檔內容(系統優化指令)

請對webui-user這個批次檔(.bat),按滑鼠右鍵,選擇編輯,進入編輯模式。

如果你的顯卡不到8G請加這些指令,可以有效提升速度。

在第四行set COMMANDLINE_ARGS =後面加下面的這個指令

 --xformers(9系列以前顯卡可能不適用)

4GVram

--medvram

2GVram(會很慢可能更適合使用線上版)

--lowvram

因為我的顯卡是3050TI,是4G的顯卡,因此我是這樣加

set COMMANDLINE_ARGS=--xformers --medvram


步驟8:安裝主程式

請點擊剛剛編輯的那個webui-user.bat批次檔,記得安裝過程不要去動到或關閉軟體開啟的視窗。安裝的時間大概要10分鐘左右,請耐心等候。

安裝完畢以後,系統會自動執行,你會發現安裝的DOS介面中,出現了一行網路位址,代表已經安裝完畢了。此時請不要把DOS介面的視窗關閉,你在使用過程中,這個視窗都不能關閉。


步驟9:安裝一些擴充功能

大家或許有聽說過,AI生成的圖片,常常會有毀容或是手腳變形的情況,這些情況發生的成因各有不同,很難快速的說明。除了在最關鍵的解析度和提詞上來控制外,也有一些可以修正這些狀況的擴充檔案,可以下載來使用。

臉部修正(GFPGAN )

https://github.com/TencentARC/GFPGAN 


進入網站中,到下方的介紹說明中,有一行"
Add V1.4 model, which produces slightly more details and better identity than V1.3."

點擊V1.4 model,就可以下載最新的版本。下載的檔案為GFPGANv1.4.pth。

或是直接使用下面這個連結也可以。

https://github.com/TencentARC/GFPGAN/releases/download/v1.3.0/GFPGANv1.4.pth

請把下載的這個檔案,放到你安裝程式的資料夾中,位置如下: 

X:\stable-diffusion-webui\models\GFPGAN

正常來說這樣就可以順利運行,在你的WebUI介面中,也會多一個面部修復的選項,可以一定程度上維持臉部的正常。

另外,還有身體和手的補充套件。

https://huggingface.co/lllyasviel/ControlNet/resolve/main/annotator/ckpts/body_pose_model.pth

https://huggingface.co/lllyasviel/ControlNet/resolve/main/annotator/ckpts/hand_pose_model.pth

請把下載的這兩個檔案,放到你安裝程式的資料夾中,位置如下: 

X:\stable-diffusion-webui-master\extensions\sd-webui-controlnet\annotator\openpose

再次說明,這些補充套件都只是能一定程度的修正這些異常,並不是真的能解決這些問題。真的要解決這些問題還要靠其他的方式才行。


步驟10:開始使用WebUI

之後要使用SD繪圖時,都要點擊webui-user.bat,程式運行到出現網路位址時才能使用,使用過程中DOS介面都不能關閉。

當程式運行到那行網址出現後,請開啟你的Google Chrome瀏覽器,並執行那一串網址,就可以開啟WebUI開始繪圖了。

http://127.0.0.1:7860/

進入介面後,可以到設定-使用者介面-最下面可以更換語文別,更換繁體中文後需要重新載入介面,程序如下:

 上方標籤點選Settings(設定)


進入設定頁面後,左側請選擇User interface(使用者介面)這個選項,進入後最下方Localization選項中,選擇zh_TW。


再到頁面最上方,先按Apply Setting套用設定,再按最右邊的Reload UI重新載入介面,就可以更換成中文介面了。由於介面中文化目前並非官方推出,而是熱心的網友自行修正的,因此難免有遺漏,而且版本更新後,中文化未必能夠繼續使用。雖然如此還是非常感謝熱心的網友們提供這麼重要的資源。


以上為基本安裝的步驟,使用方式我們下一篇再來繼續說明。

2022年8月29日 星期一

RHINO基礎題範例-哨子

 RHINO基礎題範例-哨子,屬於基礎教學,可強化對於繪製的基礎觀念。

透過繪製生活中常見的哨子,來了解基礎指令的應用。 偏重2D繪製的基礎練習,除了建模的邏輯,也訓練2D繪圖中鎖正切點的繪圖應用,另外特別練習了轉工程圖以及尺寸標註的技巧。 主要應用的指令為擠出、薄殼、導角與布林運算等。 下方附有可參考的三視圖。


2022年8月28日 星期日

RHINO基礎題範例-馬克杯

 RHINO基礎題範例-馬克杯,屬於基礎教學,可強化對於繪製的基礎觀念。

透過繪製生活中常常看見的馬克杯,來了解基礎指令的應用。 偏重2D繪製的基礎練習,也特別練習了轉工程圖以及尺寸標註的技巧。 主要應用的指令為擠出、旋轉成形、薄殼、導角與布林運算等。 下方附有可參考的三視圖。


RHINO 練習題 範例--氣炸鍋